Choisir le matériel
Quel mini-PC, combien de RAM, quel SSD ? Le guide d'achat sans jargon pour une machine qui fait tourner un agent de code et des modèles d'IA en local.
Sur cette fiche
- 01Les trois choses qui comptent vraiment (dans l’ordre)
- 02Quelle forme de machine ?
- 03iGPU ou carte graphique dédiée ?
- 04Sobre et silencieux : parfait pour le 24 h/24
- 05Pas envie d’acheter ? L’option VPS
- 06Le tableau de recommandation
- 07Les machines que je conseille (et que j’ai testées)
- 08Les ports à vérifier avant d’acheter
- 09Questions fréquentes

Fiche vérifiée il y a 3 mois : certaines commandes ont pu changer. Signalez-le si c’est le cas.
En bref
Pour l'IA locale, la mémoire décide de tout : 32 Go pour un modèle de 30 milliards de paramètres compressé, 64 Go pour être à l'aise, 128 Go pour les plus gros. Les machines à mémoire unifiée (Ryzen AI Max, Mac, DGX Spark) en prêtent l'essentiel au processeur graphique, ce qu'aucune carte grand public ne fait. La pénurie a fait monter les prix : environ 1 400 € pour 32 Go et 2 200 € pour 64 Go en Ryzen AI Max (Framework Desktop sans SSD, 30 septembre 2026). Si le modèle reste dans le cloud, un mini-PC de 16 Go ou un vieux PC suffit.
À faire avant : Des idées de projets
Avant d’acheter quoi que ce soit, une bonne nouvelle : un agent de code branché sur un modèle dans le cloud tourne très bien sur un petit PC à quelques centaines d’euros. Pour faire tourner l’IA chez vous, c’est une autre affaire : il y a un critère qui compte plus que tous les autres, et c’est justement celui que la pénurie de mémoire a rendu cher. On démêle ça ensemble, sans jargon.
Les trois choses qui comptent vraiment (dans l’ordre)
Oubliez le marketing. Pour faire tourner de l’IA en local, voici ce qui pèse, classé du plus important au moins important.
1. La RAM, de loin le facteur n°1
C’est la décision. Un modèle d’IA, pour répondre, doit tenir en entier dans la mémoire. Pas assez de RAM, et le modèle ne se charge tout simplement pas, ou rame atrocement. Voici les paliers concrets :
- 16 Go : le minimum vital. Suffisant pour faire tourner l’agent de code (qui, lui, peut taper sur un modèle dans le cloud), mais trop juste pour un vrai modèle d’IA en local. À éviter si vous pouvez.
- 32 Go : confortable. Sur une machine à mémoire unifiée, environ 24 Go reviennent au processeur graphique : de quoi faire tourner un modèle de 30 milliards de paramètres en version quantisée (compressée), ce qui couvre déjà énormément de besoins. Bon point d’entrée.
- 64 Go : le sweet spot. C’est ici que l’IA locale devient vraiment sérieuse : vous chargez de gros modèles, vous gardez de la marge pour le système et l’agent en même temps. Si vous hésitez entre 32 et 64, prenez 64.
- 96 Go et plus : le luxe. Pour les modèles les plus lourds ou faire tourner plusieurs choses en parallèle. Sympa, mais pas nécessaire pour démarrer. C’est le palier de ma machine : 128 Go, dont 96 utilisables par le processeur graphique.
2. La bande passante mémoire, la vitesse cachée
Moins connue, mais décisive pour le confort. La bande passante mémoire, c’est la vitesse à laquelle le processeur lit la RAM. Or un modèle d’IA doit relire toute sa mémoire pour produire chaque mot. Plus la bande passante est élevée, plus les mots sortent vite (on parle de tokens par seconde). Une machine avec de la mémoire rapide « tape » son texte sous vos yeux ; une machine lente le distille mot par mot. Gardez l’œil sur ce point, surtout sur les Mac (voir plus bas), où la mémoire unifiée est particulièrement rapide.
3. Le SSD NVMe, rapide et spacieux
Les modèles sont gros : comptez ~20 Go par modèle, et vous allez vite en collectionner plusieurs. Visez un SSD NVMe de 1 To minimum. Le NVMe (et pas le vieux SSD SATA) parce que charger 20 Go en mémoire au lancement, ça doit être quasi instantané, pas une pause café.
Et le processeur, alors ?
Il compte moins que vous ne croyez pour cet usage. N’importe quel AMD Ryzen ou Intel Core des deux ou trois dernières générations fait largement l’affaire. Ne payez pas une rallonge pour le CPU le plus rapide, mettez cet argent dans la RAM. C’est elle qui décide ce que vous pourrez faire.
Quelle forme de machine ?
Plusieurs familles, toutes valables. On reste neutre, choisissez selon votre budget et vos envies.
- Mini-PC barebones ou prêts à l’emploi : Minisforum, Beelink, GMKtec, ASUS NUC. Le choix le plus souple : compacts, sobres, et sur les versions barebones vous ajoutez vous-même la RAM et le SSD, donc vous pouvez pousser la mémoire au maximum, ou commencer petit et ajouter des barrettes plus tard. Contrepartie : la mémoire en barrettes offre nettement moins de bande passante que la mémoire soudée des puces à mémoire unifiée, donc les modèles y répondent plus lentement.
- Apple Mac mini (puces M) : une excellente alternative, et même un secret bien gardé pour l’IA locale. Sa mémoire unifiée est rapide et partagée entre CPU et GPU : un Mac mini M5 Pro de 64 Go fait tourner des modèles qu’une carte graphique grand public ne peut pas charger. Petit bémol : il tourne sous macOS, pas Linux.
iGPU ou carte graphique dédiée ?
La grande question, et la réponse va peut-être vous surprendre. Pour cet usage :
- Une carte graphique NVIDIA dédiée accélère beaucoup la vitesse des modèles. Mais elle est plafonnée par sa VRAM (16 Go le plus souvent, 32 Go sur la plus chère des cartes grand public, la RTX 5090), elle ajoute du bruit, de la conso et du coût, et elle rentre rarement dans un boîtier mini.
- La plupart des gens s’en sortent très bien avec un mini-PC à processeur/iGPU + beaucoup de RAM, en faisant tourner des modèles MoE compacts (des modèles malins qui n’activent qu’une partie d’eux-mêmes à chaque réponse, voir Choisir son modèle local).
Le compromis, en clair : le GPU dédié vous donne de la vitesse, mais vous limite en taille de modèle et vous ajoute du bruit. La RAM abondante vous donne des gros modèles, plus lents mais silencieux. Pour démarrer, l’approche « beaucoup de RAM, pas de GPU » est la plus simple et la plus sereine.
Sobre et silencieux : parfait pour le 24 h/24
On le répète parce que ça compte : ces machines sont quasi silencieuses et consomment peu. Comptez 10 à 30 W au repos pour un petit mini-PC, sensiblement plus dès qu’on monte en gamme : sur un Strix Halo à mémoire unifiée, le seul domaine GPU en annonce déjà une cinquantaine. La seule mesure honnête se fait à la prise, avec un wattmètre à quinze euros. C’est exactement ce qu’il vous faut pour une boîte allumée en permanence dans un coin du bureau. Un GPU dédié casse un peu cette tranquillité, à vous de voir si la vitesse en vaut la peine.
Pas envie d’acheter ? L’option VPS
Autre voie : vous pouvez aussi ne rien acheter et louer un serveur dans le cloud, un VPS (serveur privé virtuel). C’est une machine virtuelle chez un hébergeur (Hetzner, OVH, Scaleway, DigitalOcean…), facturée au mois, déjà sous Linux et joignable de partout. Tout le reste du parcours (agent, Docker, réseau, déploiement) s’applique pareil.
C’est une voie que j’ai moins testée que le mini-PC maison, alors je la donne pour ce qu’elle est, avec ses contreparties :
- Pour : zéro matériel à acheter, rien à brancher, une IP publique et de la bande passante d’emblée, et on monte ou descend la puissance en quelques clics.
- Contre : c’est un abonnement (de quelques euros à quelques dizaines par mois, qui tournent même quand vous dormez), vos données vivent chez quelqu’un d’autre, et surtout le gros LLM local n’est pas au rendez-vous : les VPS abordables n’ont pas de GPU, donc on retombe sur l’approche hybride (orchestrateur dans le cloud, le VPS sert vos projets et, au mieux, de petits modèles). Les offres avec GPU existent, mais le prix grimpe vite.
Mon avis : pour apprendre et héberger des projets sans rien acheter, un petit VPS est un terrain de jeu très correct. Pour faire tourner de vrais modèles en local, le cœur de ce site, rien ne remplace une machine à vous, avec sa RAM et, si vous le voulez, son GPU. À vous de voir où vous placez le curseur.
Le tableau de recommandation
Trois profils, selon votre budget et votre ambition.
| Profil | RAM | Pour quoi faire | Repère |
|---|---|---|---|
| Budget découverte | 32 Go | Agent de code + un petit modèle local quantisé | Ryzen AI Max 385, 32 Go (1 429 €), ou Mac mini M6, 32 Go (2 039 €) |
| Confort (recommandé) | 64 Go | Le sweet spot : gros modèles locaux + agent, de la marge partout | Ryzen AI Max+ 395, 64 Go (2 209 €), ou Mac mini M5 Pro, 64 Go (3 649 €) |
| Costaud | 96 Go+ | Modèles les plus lourds, plusieurs charges en parallèle | Ryzen AI Max+ 395, 128 Go (3 889 €), Mac Studio M5 Max, 128 Go, DGX Spark (environ 6 100 €), ou PC + GPU dédié si vous voulez la vitesse |
Les prix Ryzen AI Max sont ceux du Framework Desktop sans SSD ni système (relevés le 30 septembre 2026). Les prix Mac sont ceux des configurations proposées par Apple, avec un SSD de 1 To (relevés le 1er octobre 2026). Le DGX Spark est le prix constaté chez LDLC le 30 septembre 2026, pour un prix conseillé de 4 699 $ par Nvidia.
Si vous ne deviez retenir qu’une ligne : visez « Confort », 64 Go, si votre budget suit. Vous ne vous sentirez pas à l’étroit dans six mois. Si 2 000 € et plus, c’est trop, la voie hybride avec un petit mini-PC reste excellente.
Les machines que je conseille (et que j’ai testées)
Assez de généralités, voici des modèles concrets, dont plusieurs passés au banc d’essai. Quatre familles, selon ce que vous voulez faire. Le comparatif complet, avec les mesures du Labo Frandroid, est dans Les machines testées.
Le mini-PC polyvalent, Minisforum M2
Mon point de départ recommandé : compact, sobre, silencieux, et taillé pour tourner 24 h/24 dans un coin. Vous y faites tourner l’agent et un modèle local quantisé sans broncher, à condition d’ajouter une seconde barrette : il est livré avec une seule, ce qui bride son processeur graphique. C’est l’équilibre encombrement / perf / prix le plus sain pour démarrer. → Mon test du Minisforum M2 sur Frandroid
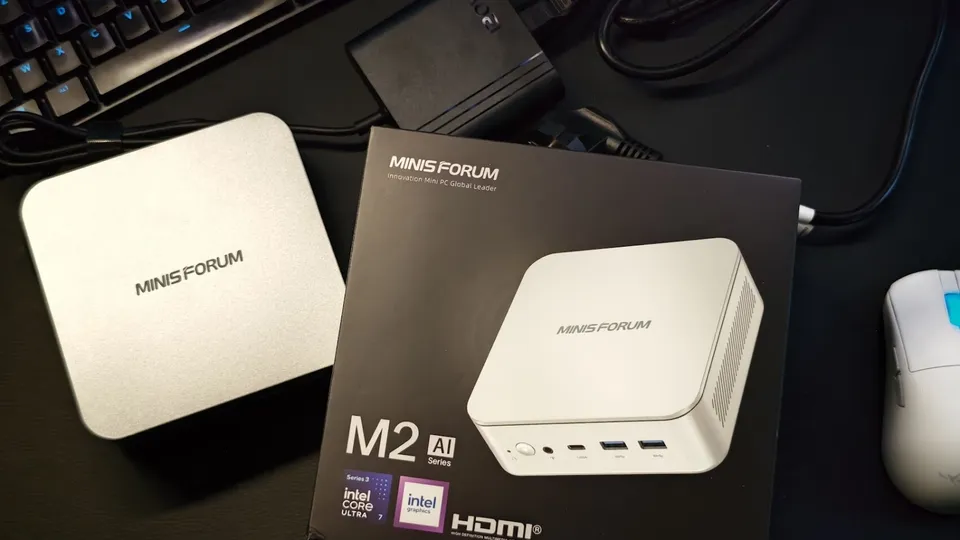
Minisforum M2
Entrée de gamme- Mémoire
- 32 Go
- Part GPU
- non précisée
- Conso
- non mesurée
- Bruit
- 43,8 dB
1 119 € constaté le 15/06/2026
Prix : 32 Go et 1 To
Un mini-PC de bureau réussi, mais peu taillé pour l'IA locale avec sa barrette unique. Ajoutez une seconde barrette avant de lancer un modèle.
- Processeur Panther Lake efficace
- Mémoire extensible jusqu'à 128 Go
- Compact et silencieux
- Une seule barrette de série, ce qui bride la mémoire
- GPU intégré modeste
La mémoire unifiée : Mac mini, Mac Studio & Framework Desktop
Si l’IA locale est votre vrai sujet, la mémoire unifiée est une arme. CPU et GPU partagent une seule mémoire, très rapide, ce qui permet de charger de gros modèles qu’aucune carte graphique grand public ne tient.
- Mac mini (M6, M5 Pro) / Mac Studio (M5 Max, M5 Ultra) : le meilleur du genre côté Apple, mémoire unifiée très rapide dans une machine minuscule et silencieuse. La gamme renouvelée en août 2026 est en vente depuis le 22 septembre : le détail des configurations et les trois cibles que je retiens sont dans Et sur un Mac mini ?. Retenez surtout qu’il faut regarder la mémoire et le nombre de cœurs graphiques, pas l’un sans l’autre.
- Framework Desktop : mon coup de cœur côté mémoire unifiée sous x86 : il embarque une puce AMD à mémoire unifiée généreuse et très rapide, réparable et ouvert comme tout ce que fait Framework. Excellent hôte pour des modèles locaux costauds, et il tourne sous Linux. Il existe en 32 Go, 64 Go et 128 Go, et se précommande avec la nouvelle puce Ryzen AI Max+ PRO 495 et 192 Go (7 659 € sans SSD, premier lot expédié en novembre selon Framework, prix relevé le 30 septembre 2026). → Mon test du Framework Desktop sur Frandroid
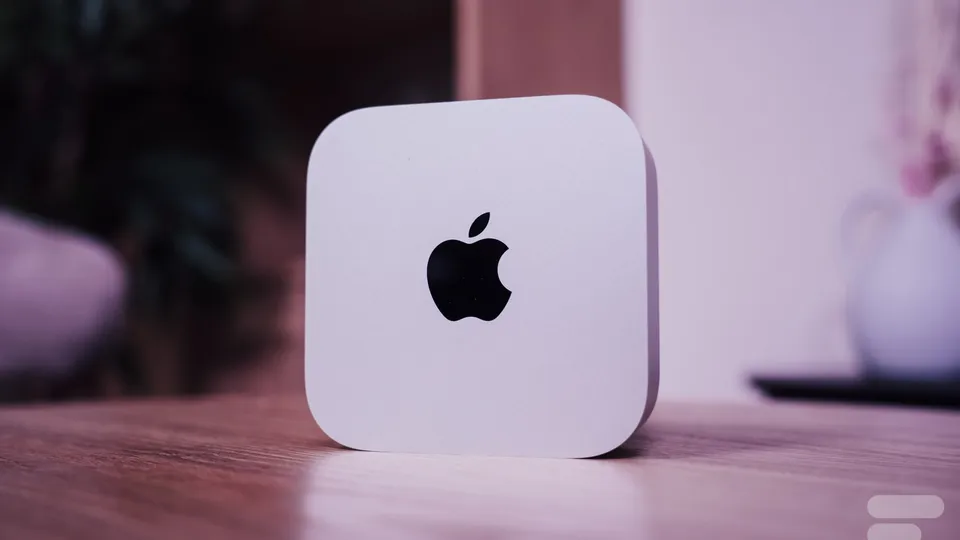
Apple Mac mini M6
Entrée de gamme- Mémoire
- 24 Go unifiés
- Part GPU
- jusqu'à 17,8 Go
- Conso
- non mesurée
- Bruit
- non mesuré
1 049 € constaté le 30/09/2026
Prix : prix de départ (16 Go) ; la 24 Go testée coûte plus
Labo Frandroid 33,1 jetons/s sur 7B
Le Mac le plus simple pour l'IA locale : rapide et silencieux. Avec 24 Go, les modèles de 30B débordent déjà : visez plus de mémoire pour aller au-delà.
- Silencieux même en pleine charge
- 69 jetons par seconde sur un modèle 3B au Labo
- Format ultra compact
- Seuls 17,8 Go sur 24 servent au modèle
- Prix en hausse et options hors de prix
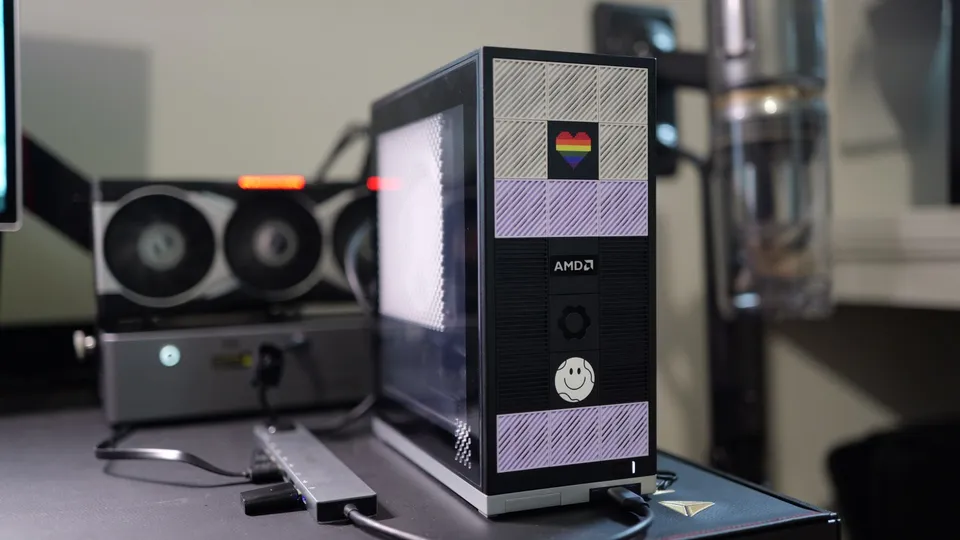
Framework Desktop
Station 128 Go- Mémoire
- 128 Go unifiés
- Part GPU
- jusqu'à 96 Go
- Conso
- non mesurée
- Bruit
- non mesuré
3 889 € constaté le 30/09/2026
Prix : en kit, 128 Go, sans SSD ni système
Le Ryzen AI Max+ 395 dans un boîtier réparable et bien suivi sous Linux. Vous payez cher ce sérieux, surtout depuis la flambée de la mémoire.
- 128 Go de mémoire unifiée pour les gros modèles
- Réparabilité exemplaire
- Très bon support de Linux
- Prix devenu très élevé avec la crise de la mémoire
- Finition plastique qui divise
Le prix affiché pour le Mac mini M6 est celui de la version de base à 16 Go ; celui du Framework Desktop s’entend sans SSD ni système. Les autres machines à mémoire unifiée testées (GMKtec EVO-X2 et EVO-X3, DGX Spark) sont comparées dans Les machines testées.
Pourquoi la mémoire unifiée change la donne (et comment la repérer)
C’est le point technique le plus important de toute cette fiche, alors prenons le temps. Sur un PC classique, il y a deux mémoires séparées : la RAM du processeur, et la VRAM de la carte graphique. Le GPU ne peut utiliser que sa VRAM, souvent 8, 12 ou 16 Go, et pas un octet de plus. C’est un mur.
La mémoire unifiée, elle, casse ce mur : CPU et GPU partagent un seul et même pool de mémoire, très rapide. Vous pouvez donc allouer une grosse part de cette mémoire au GPU quand un modèle d’IA en a besoin. Concrètement : une machine à mémoire unifiée de 64 Go peut présenter, disons, 48 Go « comme de la VRAM » à un modèle. Aucune carte graphique grand public ne sait faire ça. C’est ce qui permet à un petit Mac mini ou à un Framework Desktop de charger des modèles qu’une GeForce RTX 5080 de 16 Go, vendue autour de 1 850 € (LDLC, 30 septembre 2026), ne peut tout simplement pas tenir.
La grosse bande passante, un PC avec carte graphique dédiée
Vous visez la vitesse maximale, ou vous faites aussi du créatif (génération d’images, vidéo, entraînement) ? Là, une vraie carte graphique avec sa mémoire dédiée prend tout son sens : sa bande passante écrase celle d’un iGPU, et les tokens fusent. Mon conseil pour démarrer : la GeForce RTX 5060 Ti 16 Go, la carte Nvidia la moins chère avec 16 Go de VRAM. La pénurie a fait grimper son prix : la moins chère en stock était à 819,95 € chez LDLC le 30 septembre 2026. Côté AMD, la Radeon RX 9060 XT 16 Go était au même niveau (799,95 €), et l’Intel Arc Pro B60 offre 24 Go pour 799,95 €, avec un logiciel moins rodé.
Les ports à vérifier avant d’acheter
Avant de cliquer « commander », passez cette petite check-list :
0 étape sur 3 faite Vos cases cochées restent dans ce navigateur.
-
Ethernet 2.5 GbE
Pas obligatoire, mais agréable : du réseau filaire rapide, c’est confortable pour transférer des modèles ou servir un projet. Le Wi-Fi dépanne, le câble rassure.
-
Assez d'USB
De quoi brancher un clavier, une clé d’install, un disque externe pour les sauvegardes. Vérifiez qu’il y a au moins deux ou trois ports.
-
RAM en SODIMM, évolutive
Le détail qui change tout : sur les modèles barebones, la RAM est en barrettes SODIMM que vous installez vous-même. Vous choisissez votre capacité et vous pouvez upgrader plus tard. Fuyez (pour ce projet) les mini-PC classiques où la RAM est soudée et figée. Exception : les machines à mémoire unifiée (Mac, Ryzen AI Max, DGX Spark), dont la mémoire soudée est justement ce qui la rend rapide. Elle se choisit à l’achat et ne se change plus, alors prenez large.
Toutes les commandes de cette fiche
Questions fréquentes
Faut-il une carte graphique dédiée pour faire tourner une IA en local ?
Ce n'est pas indispensable. Une carte dédiée accélère nettement les réponses, mais elle est plafonnée par sa mémoire vidéo (16 Go le plus souvent, 32 Go sur une RTX 5090) et ajoute du bruit, de la consommation et du coût. Pour démarrer, un mini-PC avec beaucoup de mémoire et sans carte graphique reste l'approche la plus simple et la plus sereine.
Le processeur compte-t-il pour l'IA locale ?
Moins qu'on ne le croit. N'importe quel AMD Ryzen ou Intel Core des deux ou trois dernières générations fait l'affaire. Mieux vaut mettre l'argent dans la mémoire, puis regarder la bande passante mémoire, qui fixe la vitesse à laquelle les mots sortent, et prévoir un SSD NVMe d'au moins 1 To.
Que veut dire « quantisé » pour un modèle d'IA ?
Quantiser un modèle, c'est le compresser pour qu'il occupe moins de mémoire, au prix d'une petite perte de qualité souvent imperceptible. Un modèle de 30 milliards de paramètres passe ainsi d'environ 60 Go à environ 20 Go, ce qui le rend utilisable sur un mini-PC.
Carte Nvidia ou AMD pour l'IA locale ?
Nvidia, avec sa plateforme CUDA, est le standard de fait : presque tout l'écosystème IA est pensé pour elle d'abord, et tout marche sans bidouille. AMD, avec ROCm, est plus ouvert et imbattable sur le prix par Go de mémoire vidéo, mais il faut parfois mettre les mains dedans selon la carte et l'outil. Pour démarrer côté Nvidia, la RTX 5060 Ti 16 Go est la carte la moins chère avec 16 Go de mémoire vidéo.
Peut-on louer un VPS au lieu d'acheter un mini-PC ?
Oui. Un VPS loué au mois chez un hébergeur comme Hetzner, OVH, Scaleway ou DigitalOcean suffit pour apprendre et héberger des projets, et tout le reste du parcours s'y applique. En contrepartie, c'est un abonnement, vos données vivent chez quelqu'un d'autre, et les offres abordables n'ont pas de processeur graphique, donc pas de gros modèle en local.
Les termes de cette fiche : AgentMémoire unifiéeCPU (processeur)ParamètresQuantisationBande passante mémoireTokenSSD NVMeGPU (carte graphique)LinuxVRAMVPSDockerLLMOrchestrateur
Une erreur ?
Une commande ne marche plus, un prix a changé ?
Les outils bougent tous les mois. Dites-moi ce qui cloche dans cette fiche, je corrige et je redate.
